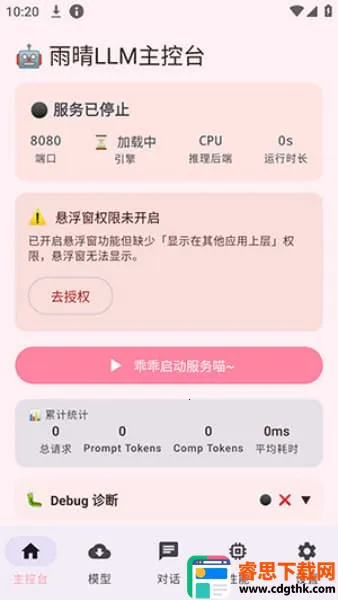
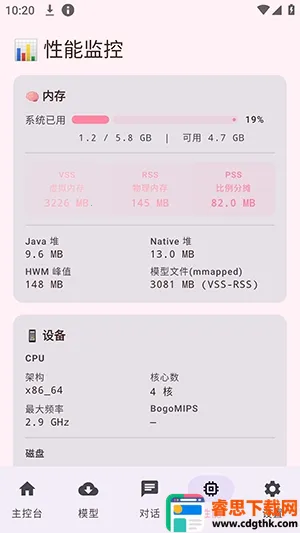
雨晴LLM是运行于Android平台的本地离线LLM推理服务器。它支持CPU与GPU推理后端自由切换,适配不同机型。配套实用功能,如实时性能统计仪表板、可拖动悬浮窗口等。能解决老旧设备运行慢、模型下载不灵活等痛点。兼容OpenAI规范API,方便对接各类工具。还具备持久后台服务能力,支持多客户端接入,可自定义推理参数,优化资源调度,满足多样需求。
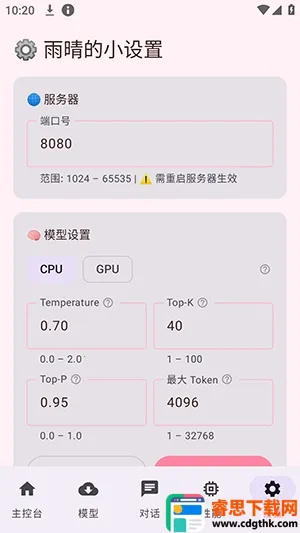
1. 灵活切换推理后端:支持CPU与GPU推理后端自由切换,能依据手机硬件配置及功耗需求自主选择,兼顾老旧设备兼容性与高性能机型加速推理,适配多样使用场景。
2. 可视化运行监控:配备实时统计仪表板,可直观展示推理速度、内存占用、负载状态等运行数据,方便用户监控模型运行状况,及时调整参数优化推理表现。
3. 多客户端接入:支持多客户端同时接入本地API服务,局域网内其他设备也能访问推理接口,使手机成为家庭离线AI中枢,供多终端调用大模型能力。
4. 优化资源调度:优化移动端资源调度策略,后台推理时有效管控功耗与内存占用,减少卡顿闪退,延长离线推理任务持续运行时长。
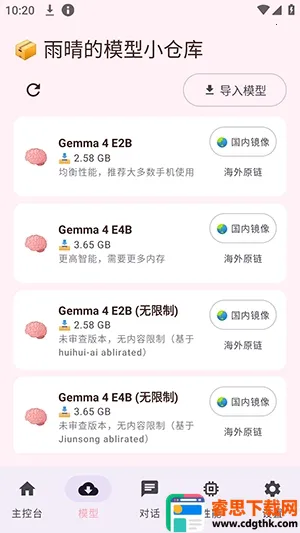
1、安装 APK,授予存储、后台悬浮窗、后台运行权限;
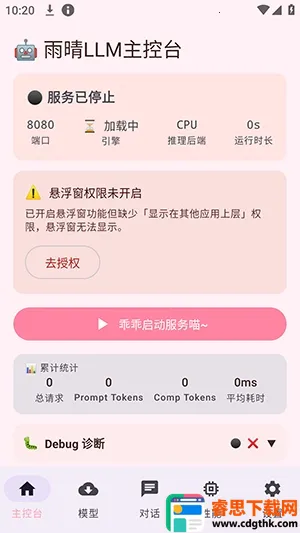
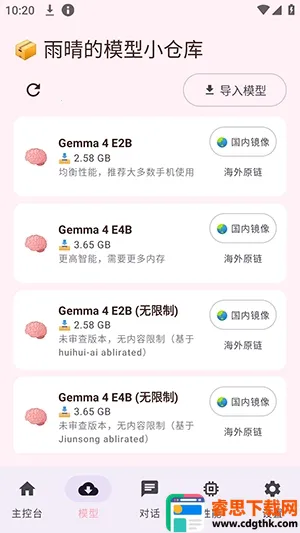
2、进入模型管理页面,下载对应 Gemma量化模型文件;
3、选择 CPU/GPU推理后端,启动本地 API服务;
4、使用任意兼容 OpenAI API的客户端,填写本地地址 http://127.0.0.1:8080即可调用;
5、悬浮窗可随时查看生成进度、切换模型、关闭服务。
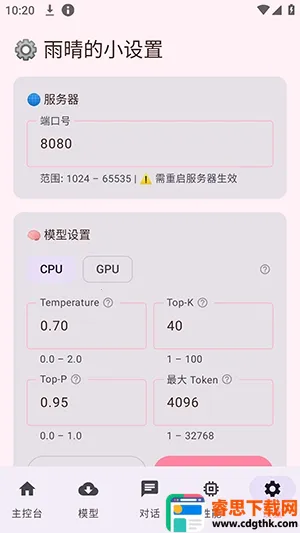
1. 支持CPU与GPU推理后端自由切换,能依据手机硬件配置和功耗需求自主抉择,兼顾老旧设备与高性能机型。
2. 配备实时统计仪表板,可视化展示推理速度、内存占用等运行数据,方便监控模型状态并调整参数。
3. 支持持久后台服务模式,启动推理服务后可切至后台持续运行,不中断推理任务,稳定提供AI接口服务。
4. 模型采用独立下载机制,用户按需获取权重文件导入,不强制捆绑内置模型,灵活平衡存储与推理效果。
雨晴LLM这款运行于Android平台的本地离线LLM推理服务器表现出色。它支持CPU与GPU推理后端自由切换,能依据手机硬件配置和功耗需求灵活选择,兼顾不同设备。配备实时性能统计仪表板,可直观监控推理负载。提供持久后台服务能力,模型独立下载,灵活按需选择权重。还内置网络服务,开放API端点,对接成熟AI生态。其可拖动悬浮窗口方便调控服务,多任务并行操作便捷高效,优化资源调度策略,减少卡顿闪退,支持多客户端接入,是一款很实用的推理服务器。